
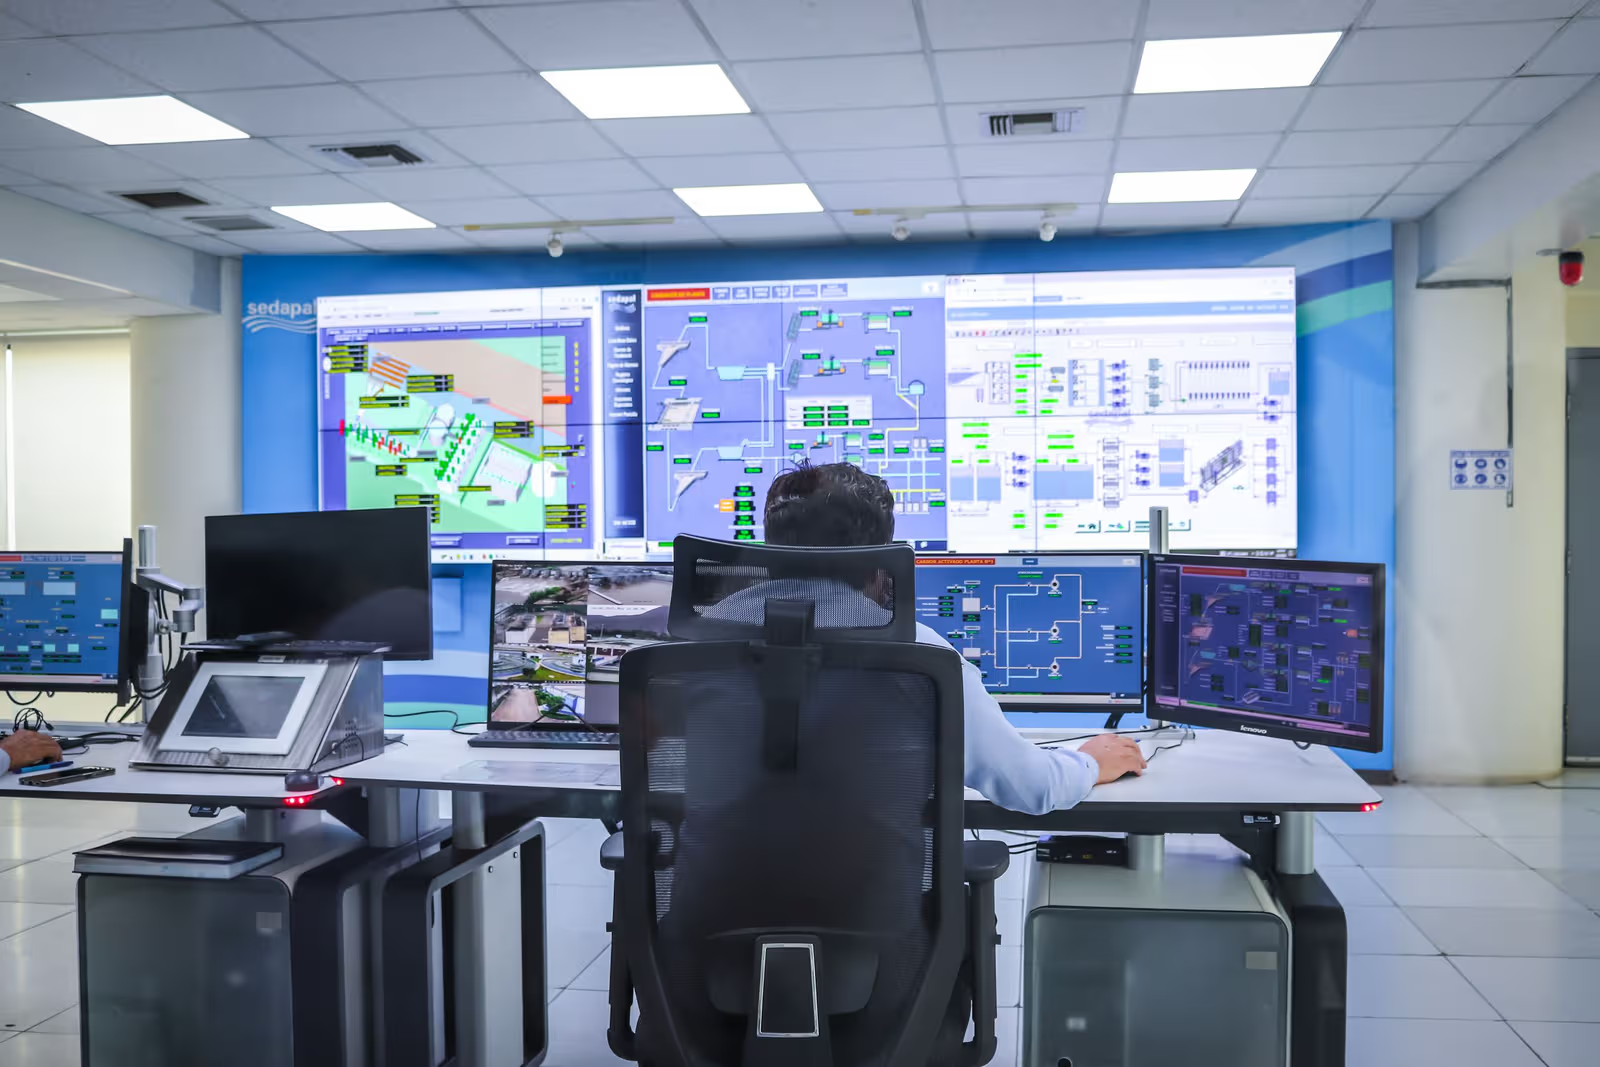
Dowody, które pozwalają audytować obsługę alertów
Klasyfikacja alertów zamienia sygnały z EDR, zapory sieciowej, Microsoft 365 i monitoringu w decyzje P1-P4, eskalację i dowody reakcji. Przegląd powinien potwierdzić źródła alertów, zasady priorytetów, właścicieli, SLA, kontakty awaryjne, zapisy decyzji i raport po incydencie.
Spójny zakres operacyjny
Administracja systemami, monitoring i zespół bezpieczeństwa uzgadniają przekazywanie alertów oraz odpowiedzialność za kolejne działania.
Odpowiedzialność za reakcję
Nazwani właściciele, historia ticketów, zasady eskalacji i raportowanie dla zarządu czynią usługę mierzalną.
Bezpośrednia konsultacja
Przed rozmową zbierz przykładowe alerty, źródła logów, obecną matrycę priorytetów i czasy reakcji. Na tej podstawie zawęzimy zakres porządkowania triage'u oraz eskalacji.
Jak ustalić, czy alert wskazuje incydent
Wstępna ocena alertu (triage) ustala jego wiarygodność, wpływ i pilność. Alert z EDR, firewall, Microsoft 365, SIEM albo monitoringu infrastruktury jest tylko sygnałem. Zespół musi szybko ustalić, czy dotyczy systemu krytycznego, konta uprzywilejowanego, danych klienta, ransomware, awarii czy fałszywego alarmu. Bez tej klasyfikacji organizacja reaguje chaotycznie: ignoruje ważne zdarzenia albo zużywa czas na niski priorytet.
SOC/SIEM/SOAR
Korelacja logów, scenariusze detekcji, eskalacja i automatyzacja powtarzalnych kroków reakcji.
EDR
Kontekst z urządzeń końcowych: procesy, izolacja hosta, ślady malware i działania użytkownika.
Monitoring IT
Rozróżnienie awarii technicznej, przeciążenia, niedostępności usługi i sygnałów bezpieczeństwa.
Klasyfikacja P1-P4 w praktyce
P1-P4 to przykładowy model organizacyjny, a poniższe zdarzenia są ilustracjami, nie automatyczną klasyfikacją. O priorytecie decydują wpływ, zasięg, pilność i wiarygodność detekcji. Aktywnie wykorzystywana podatność, przejęcie sesji po obejściu MFA lub malware na krytycznym urządzeniu mogą wymagać P1. Zmieniaj ocenę wraz z nowymi dowodami.
- P1 krytyczny: ransomware, aktywny atak na konto administratora, wyciek danych, przejęty serwer, niedostępny system produkcyjny.
- P2 wysoki: malware na stacji, nietypowe logowanie z ryzykownej lokalizacji, eskalacja uprawnień, podejrzany ruch z serwera.
- P3 średni: podatna wersja usługi, powtarzalne błędy logowania, naruszenie polityki MFA, alert z pojedynczego urządzenia bez potwierdzenia.
- P4 niski: zdarzenie informacyjne, test, znana anomalia, alert wymagający trendu lub cyklicznego przeglądu.
- Każdy alert powinien mieć właściciela, termin reakcji, decyzję i krótki opis dowodów.
Na czym opiera się klasyfikacja alertów o wykrytym zagrożeniu?
Priorytet alertu wynika z zagrożonego zasobu, wiarygodności sygnału, wpływu na biznes i możliwości rozprzestrzenienia. Dla każdego poziomu określ osobę odpowiedzialną, kanał powiadomienia, uprawnione działania i czas reakcji wynikający z umowy lub procedury. Zapisz uzasadnienie klasyfikacji oraz wynik weryfikacji, także gdy alert okazał się fałszywy.
- Oceniaj alert według wpływu na poufność, integralność i dostępność danych oraz usług.
- Uwzględniaj typ zasobu: konto administratora, serwer, aplikacja biznesowa, urządzenie sieciowe, stacja użytkownika albo usługa chmurowa.
- Dodawaj kontekst biznesowy, bo ten sam alert na systemie testowym i produkcyjnym wymaga innej reakcji.
- W outsourcingu IT powiąż klasyfikację z SLA, eskalacją, ticketem i odpowiedzialnością osoby dyżurnej.
- Zamykaj alert decyzją i dowodami, a nie samym statusem "rozwiązane".
Przykładowe punkty kontroli po 30, 60 i 90 minutach
To punkty sprawdzenia postępu uzgodnionego scenariusza P1, nie czas oczekiwania na reakcję. Izolację, zabezpieczenie dowodów, eskalację i ograniczenie przejętych kont prowadź niezwłocznie i równolegle według ryzyka oraz uprawnień. SLA i instrukcja reagowania określają odpowiedzialność; przykład nie zastępuje obowiązujących terminów zgłoszeń.
- Po 30 minutach: sprawdź potwierdzenie alertu, właściciela, zabezpieczenie śladów i skuteczność pierwszych działań ograniczających szkody.
- Po 60 minutach: zaktualizuj zasięg, oś czasu i priorytet; zweryfikuj ochronę kont, logów oraz komunikację z właściwymi osobami.
- Po 90 minutach: oceń potrzebę dodatkowych zasobów i plan odtworzenia. Przywracaj system po sprawdzeniu kopii, usunięciu przyczyny oraz akceptacji warunków powrotu.
- Po incydencie: przygotuj raport, listę luk, właścicieli działań i dowody, które można pokazać audytorowi albo klientowi.
Monitorowanie poprawności działania infrastruktury IT w celu wykrywania problemów
Alerty bezpieczeństwa często zaczynają się od monitorowania parametrów technicznych: miejsca na dysku, obciążenia procesora, niedostępności usługi, nietypowego ruchu sieciowego, błędów logowania lub aktywności procesu na stacji roboczej. Sam spadek wydajności nie zawsze jest atakiem, ale może być sygnałem ransomware, wycieku danych, awarii sprzętu albo błędnej konfiguracji. Skuteczny monitoring łączy wykresy, historię błędów, logi i system zgłoszeniowy, aby informatyk mógł szybciej określić skalę problemu.
Monitoring IT
Obserwacja usług, serwerów, sieci, wydajności i dostępności zanim problem stanie się przestojem.
SOC/SIEM/SOAR
Korelacja zdarzeń bezpieczeństwa z wielu źródeł, eskalacja i automatyzacja powtarzalnych kroków.
Helpdesk IT
Ticket, właściciel, SLA, komunikacja z użytkownikiem i dowody obsługi zdarzenia.
Co musi być w procedurze alertowania
Procedura nie powinna być długa, ale musi być używalna pod presją. Najważniejsze są progi, kanały kontaktu, uprawnienia do decyzji oraz to, kto może odciąć system, zablokować konto albo uruchomić odtwarzanie.
Uprawnienia i MFA
Konta administratorów, VPN i Microsoft 365 powinny mieć silne uwierzytelnianie oraz jasne zasady blokowania.
Backup i odtwarzanie
Reakcja na ransomware wymaga sprawdzonych kopii, RTO/RPO i decyzji, kiedy odtwarzać środowisko.
Audyt NIS2
Dla podmiotów objętych NIS2/KSC zakres klasyfikacji, zgłoszeń i dowodów ustala się według właściwych przepisów. Sam model priorytetów nie potwierdza zgodności.
Kto odbiera alert i podejmuje decyzję o reakcji
Alert ma sens tylko wtedy, gdy trafia do osoby lub zespołu, który ma kompetencje, uprawnienia i czas na reakcję. W dużych organizacjach problemem jest nie tylko technologia, ale także podział odpowiedzialności: kto blokuje konto, kto izoluje host, kto komunikuje się z zarządem, kto analizuje backup i kto decyduje o eskalacji do zewnętrznych specjalistów. Jeżeli kompetencji brakuje wewnątrz firmy, nadzór nad bezpieczeństwem może być wspierany przez outsourcing IT, SOC albo stałą administrację.
- Przypisz alerty do ról, a nie do anonimowej skrzynki pocztowej.
- Ustal kanały komunikacji: e-mail, SMS, telefon, ticket, komunikator i tryb po godzinach pracy.
- Zdefiniuj, kto może podjąć decyzję o izolacji hosta, blokadzie konta, odłączeniu usługi albo odtworzeniu danych.
- Szkol pracowników technicznych i właścicieli biznesowych, aby wiedzieli, kiedy alert jest incydentem bezpieczeństwa, a kiedy awarią operacyjną.
- Sprawdzaj po incydencie, czy kompetencje, procedury i narzędzia były wystarczające.
Najczęstsze błędy w obsłudze alertów
Najgroźniejszy błąd to alert bez właściciela. Kolejne problemy to zbyt duża liczba powiadomień, brak strojenia reguł, brak integracji z ticketami, nieustalone SLA reakcji i brak przeglądu po incydencie.
- Alert trafia na wspólną skrzynkę, ale nikt nie ma obowiązku podjąć decyzji.
- System generuje setki powiadomień, więc zespół przestaje odróżniać sygnał od szumu.
- Brakuje informacji, czy alert dotyczy systemu krytycznego, konta VIP albo danych osobowych.
- Reakcja kończy się na zamknięciu ticketu, bez korekty reguł, MFA, segmentacji albo backupu.
- Nie ma raportu z osi czasu, dowodów i rekomendacji po incydencie.
Jak Virtline pomaga uporządkować reakcję na alerty
Virtline może sprawdzić źródła logów, scenariusze alertów, sposób eskalacji, integrację z helpdeskiem i praktyczne procedury reakcji. Efektem nie jest sama lista narzędzi, lecz proces, który pozwala szybciej podejmować decyzje i dokumentować działania.
Cyberbezpieczeństwo
Przegląd ryzyk, kont, dostępu, podatności, backupu i kontroli operacyjnych.
SOC/SIEM/SOAR
Projektowanie detekcji, korelacja logów i scenariusze automatyzacji reakcji.
Kontakt
Wspólnie ustalimy, które alerty wymagają natychmiastowego triage i kto powinien podejmować decyzje.
Powiązane artykuły
Reakcja na alerty łączy monitoring, firewall, backup, zarządzanie ryzykiem i outsourcing IT. Te tematy pomagają zbudować pełny proces, w którym wykrycie zdarzenia prowadzi do decyzji, dowodu i usprawnienia, a nie tylko do kolejnego powiadomienia.
Jak działa firewall
Kontrola ruchu, logi, VPN i segmentacja jako źródła alertów oraz dowodów bezpieczeństwa.
Zarządzanie incydentami
Polityka, role, eskalacja i dokumentowanie działań po naruszeniu bezpieczeństwa.
Outsourcing IT czy samodzielne zarządzanie
Kiedy wewnętrzny zespół wystarcza, a kiedy warto wesprzeć reakcję zewnętrznym partnerem.







































